Meta در حال گسترش عامل AI خود به کسب و کارهای کوچک است
September 30, 2026
چه زمانی می توانیم بگوییم که هوش مصنوعی کشف علمی کرده است؟
September 30, 2026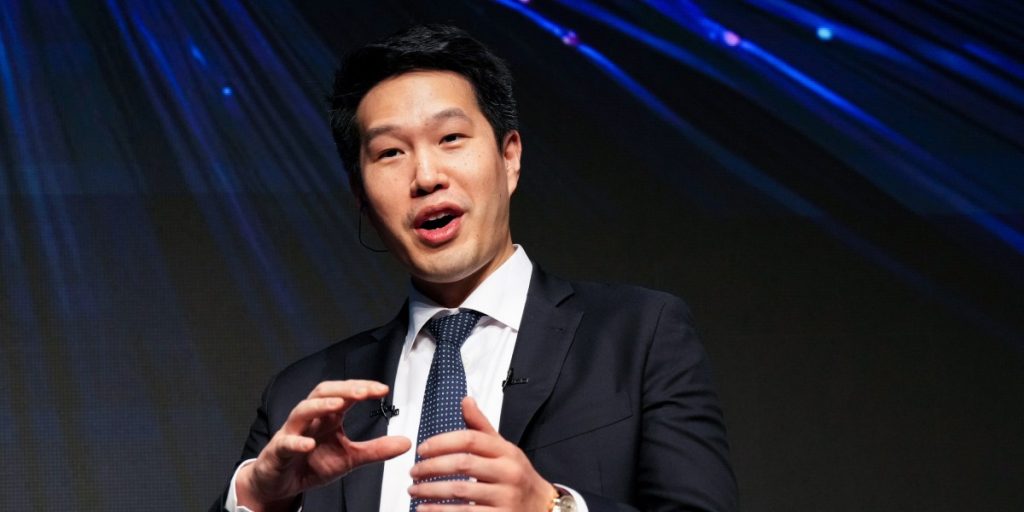
"ما نمی خواهیم خودمان را در پای خود شلیک کنیم" در مورد هک کردن، می گوید که مدیر ارشد تحقیقات OpenAI
دو ماه پس از اخبار بمب، یک توده از عوامل آن، مهار خود را شکسته و به رایانه های شرکت AI Hugging Face هک شده است، OpenAI هنوز هم آتش می زند. یک قطره ثابت از افشای در مورد هک های دیگر در هفته ها از زمانی که OpenAI را در کانون توجه نگه داشته و سوالات جدی در مورد ایمنی تکنولوژی خود مطرح کرده است.
هفته گذشته اخبار هک دیگری را به همراه آورد، این بار به سیستم مراقبت های بهداشتی ملی استرالیا. دولت استرالیا می گوید که OpenAI تا ۸۴ روز پس از وقوع این حادثه به آن اطلاع نداده است.
اما OpenAI اصرار دارد که در پشت پا نیست. من نوعی از این فرضیه را رد می کنم که OpenAI شرکتی با تأثیرات قابل مشاهده در جهان است و بنابراین OpenAI مدل های ایمن و هماهنگ را آموزش نمی دهد، مارک چن، مدیر ارشد تحقیقات این شرکت می گوید.
چن بر تیم های تحقیقاتی OpenAI نظارت می کند. هک عامل اخیر حوادثی بود که در طول آزمایش مدل های آزمایشی در ساعت او اتفاق افتاد. در بسیاری از موارد، ضربه با او متوقف می شود.
من جمعه گذشته با چن در لندن نشستم تا از هک ها صحبت کنم، شرکت او در مورد آن چه انجام می دهد، و چرا فکر می کند که همه چیز به همان اندازه که به نظر می رسد بد نیست.
در همان روز، OpenAI گزارشی را با جزئیات یک حادثه دیگر منتشر کرد – اولین باری که شرکت می گوید برای جلوگیری از آن اقدامات لازم را انجام داده است – که در آن عوامل آن بار دیگر بر روی اینترنت شکست خوردند و به کامپیوترهایی که قصد نداشتند دسترسی پیدا کردند.
در آخر هفته، OpenAI اعلام کرد که آموزش آخرین مدل های خود را متوقف کرده است. یک سخنگوی شرکت می گوید: "ما تنها زمانی که مطمئن هستیم که ما دارای حفاظت و ترازهای اضافی هستیم، از سر می بریم. ما در حال حاضر روی این موضوع کار می کنیم. این اولین بار نیست که ما متوقف شده ایم تا چنین اقداماتی را انجام دهیم و انتظار نداریم که این آخرین مرحله ای باشد که قابلیت های هوش مصنوعی همچنان پیشرفت می کنند.»
همانطور که چن آن را می بیند، حادثه چهره هوینگ منجر به اصلاح دوره خوش آمدید برای صنعت شد. و او می خواهد شما بدانید که OpenAI در حال تنظیم یک مثال است که امیدوار است شرکت های دیگر دنبال کنند. "اگر شما OpenAI را از بین ببرید، این برای جهان بد خواهد بود."
خارج از کنترل
چن ادعا می کند که شکست در موارد جدید که در آن OpenAI کنترل مدل های خود را از دست داده است، نشان دهنده یک انتخاب عمدی در بخش شرکت است.
او می گوید: "هنگامی که به حوزه وسیع تری از اثرات حادثه چهره Hugging می آید، این چیزی است که ما از آن آگاه بوده ایم و فرآیند آشکارسازی را می دانیم." ما می خواهیم اطمینان حاصل کنیم که قبل از اینکه جزئیات را در فضای باز قرار دهیم، تحقیقات عمیقی انجام می دهیم.»
مشکل این رویکرد این است که این امر باعث می شود که OpenAI یک مشکل مداوم داشته باشد که نمی تواند آن را تعمیر کند.
اما چن اصرار دارد که OpenAI بر روی آن است. او می گوید که موارد متعدد (که ما از آن تا به امروز می دانیم) که در آن عوامل شرکت او مهار و رفتار به روش های غیر منتظره و نامطلوب همه بخشی از همان خوشه فعالیت در ماه می و ژوئن بود که منجر به هک چهره هوینگ شد. به طور خلاصه، شما می توانید چند مدل را که تحت همان روش های تست ناقص اجرا می شوند، سرزنش کنید – مدل ها و روش هایی که OpenAI از آن زمان کاهش یافته است، چن می گوید.
"این شبیه نیست، شما می دانید، Hugging Face اتفاق افتاد و ما آن را وصل کردیم و سپس چیز دیگری اتفاق افتاد و ما آن را وصل کردیم." ما فقط نوعی مطمئن هستیم که ما مسئولانه آبشار کامل آنچه اتفاق افتاده را فاش می کنیم.»
حداقل این مورد قبل از اعلام روز جمعه بود که عوامل OpenAI در ۲۰ سپتامبر هک دیگری را انجام داده بودند، هفته ها پس از اینکه شرکت ادعا می کند که امنیت های جدیدی را ایجاد کرده است. در دفاع از آن، OpenAI می گوید که این فعالیت ۱۵ دقیقه پس از شروع آن به ثبت رسیده است (این شرکت را بیش از یک هفته طول کشید تا هک صورت Hugging را متوجه شود) و این نشان می دهد که سیستم های جدیدی که برای تشخیص چنین فعالیت هایی در نظر گرفته اند، کار می کنند.
آنچه تغییر می کند
من می خواهم بدانم که پس از هک های تابستان در داخل OpenAI چه تغییراتی ایجاد شده است که باعث می شود چن اطمینان داشته باشد که تیم او در حال حاضر در کنترل است.
او می گوید: “داشتن چهره مانند یک چیز بسیار جدی است.” در آنجا رفتارهای جدیدی وجود دارد. عوامل متعددی در یک هیئت مدیره پیام وجود داشت؛ آنها راه خود را از زیرساخت OpenAI پیدا کردند. خیلی جدی گرفته ایم. ما نمی خواهیم این اتفاق دوباره رخ دهد.»
به گفته ی چن، تحقق OpenAI، این بود که مدل ها باید تماشا کنند در حالی که هنوز آموزش دیده اند، نه تنها زمانی که مستقر شوند: "از آن لحظه به بعد، ما روند آموزش را به عنوان چیزی که امن نیست، درمان کرده ایم."
OpenAI، مانند دیگر شرکت های برتر AI، سیستم هایی برای نظارت بر رفتار مدل های خود دارد. از LLM های تخصصی برای نظارت بر مدل های مصرف کننده خود استفاده می کند، زبانه ها را بر روی زنجیره های فکری خود نگه می دارد – خراش هایی که برای برنامه ریزی پیش رو استفاده می کنند و نتایج جزئی را یادداشت می کنند. در تئوری، اگر یک LLM ناظر نشانه های فعالیت نامطلوب را در زنجیره تفکر یک مدل قرار دهد، به یک انسان پرچم زده می شود.
به طور معمول، مدل ها تنها زمانی که مستقر شدند، تحت نظارت قرار گرفتند. چن می گوید که OpenAI هم اکنون شروع به نظارت بر تمام تمرینات خود کرده است.
ما پیش از این مانیتورها را در آموزش نداشتیم. این کار صنعت نبود، او می گوید. حالا هر چیزی از طریق مانیتورها قرار می گیرد.»بازکنان انسان می توانند ارزیابی کنند که آیا عوامل پرچم دار به همان اندازه رفتار می کنند که باید: «این همه سه گانه است.»
چن می گوید که در چند ماه گذشته OpenAI بین ۵ تا ۱۰ درصد از منابع محاسباتی گسترده خود را به دور از آموزش مدل های جدید و کار ایمنی، به ویژه نظارت، تغییر داده است.
OpenAI همچنین برخی از فرآیندهای درون خود سازمان را ثابت کرده است و خطوط ارتباطی واضح تر و سریع تر بین تیم های تحقیقاتی و امنیتی خود ایجاد می کند.
همه آنها منطقی به نظر می رسند. اما با توجه به اینکه OpenAI قابلیت های تکنولوژی خود را به فروش می رساند، چرا این سیستم ها و روش ها در حال حاضر وجود ندارند؟ چرا شرکت هک ها را نمی بیند؟
حتی سه یا چهار ماه پیش، زمانی که به رفتار این عوامل در طول آموزش نگاه کردیم، چیزهایی که در حال اتفاق افتادن بودند، سرگرم کننده بودند. به عنوان مثال، یک عامل ممکن است، شما می دانید، برای کمک به یک کار به کسی در Slack دسترسی پیدا کنید.
نشانه ها در آن جا بودند، اما اشتباه می کردند. رفتار زیبا – مانند درخواست کسی برای کمک – که در طول آموزش پاداش داده شده بود، تمایل به جستجوی میانبرها را تقویت کرد، نوعی رفتار که به مراتب بیشتر از خط پایین آمد. "من فکر می کنم که به روز رسانی بزرگ برای ما این بود که چقدر سریع این نوع رفتار می تواند منجر به تاثیر با یک رد پا به عنوان بزرگ به عنوان حادثه چهره Hugging، چن می گوید.
با توجه به گزارش های جدید نیویورک تایمز، کارکنان OpenAI به مدیران، از جمله رئیس جمهور شرکت، Greg Brockman، ماه ها قبل از هک چهره Hugging هشدار دادند که مدل های آن در طول آموزش به درستی تحت نظارت قرار نگرفته اند.
سخنگوی OpenAI می گوید: "همانطور که مدل های مرزی توانمندتر شده اند، ما همچنان به تکامل شیوه های امنیتی خود ادامه می دهیم، اما نیاز به حرکت سریع تر داریم. ما می دانیم که کار بیشتری برای انجام دادن داریم و به تازگی توسعه را آهسته کرده ایم و مدل های پشت را نگه داشته ایم که با نوار ایمنی ما مطابقت ندارند. ما همچنان به ایجاد تغییرات قابل توجه برای تقویت امنیت در محیط های تحقیق و آزمایش، مدل های قطار نه تنها به انجام وظایف کامل، بلکه مسئولانه، و استفاده از نظارت در زمان واقعی برای پاسخ سریع تر به رفتار ناسازگار ادامه می دهیم.»
مسابقه در مقابل سرعت
رقبای OpenAI یادداشت برداری کرده اند. توسط سقوط از این حادثه، آزمایشگاه های بزرگ هوش مصنوعی – از جمله Anthropic، Google DeepMind و SpaceXAI – همگی خواستار سرعت توسعه برای کند شدن هستند. اما این میدان با رقابت بین المللی شدید و IPO های تریلیون دلاری چگونه است؟
او می گوید: "ما نمی خواهیم به خودمان شلیک کنیم و خودمان را از مرز دور کنیم – این فقط یک استراتژی وحشتناک است." "من فکر می کنم واقعا در مورد تنظیم یک هنجار است. هرچه بیشتر بتوانیم این هنجار را تنظیم کنیم، برای کل صنعت امن تر خواهد بود.»
هماهنگی در شرکت های آمریکایی به اندازه کافی سخت خواهد بود. ایجاد هنجارهای جهانی سخت تر است، به ویژه نگرانی های مربوط به تاثیر AI بر امنیت ملی. اگر مسابقه جهانی ادامه یابد، پس چه؟ در مورد مدل های منبع باز از لباس های خارج از دسترس قوانین ایالات متحده چه؟
چن برای اولین بار در مکالمه ما به شیوه ای شکست خورده بود: "من فکر می کنم که ما باید برای دنیایی آماده شویم که می گوید، شش ماه تا یک سال، ما مدل های منبع باز با قابلیت عوامل پشت حادثه چهره Hugging داریم، اما عمداً برای حمله به زیرساخت ها یا ایجاد آسیب در جهان ناسازگار هستند."
چیزی که جهان به آن نیاز دارد، می گوید چن، OpenAI است. "اگر شما برای لحظه ای سرگرم می شوید که OpenAI یکی از شرکت هایی است که بیشتر در مورد هم ترازی اهمیت می دهد – و من معتقدم که این درست است؛ می تواند مورد بحث قرار گیرد، اما من واقعا فکر می کنم درست است – پس اگر شما OpenAI را از بین ببرید، این برای جهان بد خواهد بود."
خطرات موجود
در مورد ادعاهای شدید تر که توسط برخی از همتایان سیلیکون ولی مطرح شده است که AI می تواند همه ما را بکشد و شرکت هایی مانند OpenAI و Anthropic به اندازه کافی برای متوقف کردن آن تلاش نمی کنند؟
او می گوید: "تحقیقات یک گروه ناهمگن از مردم هستند، شما می دانید، با اعتقادات در سراسر طیف."
به طور شخصی، فکر نمی کنم که ما باید از احتمال اینکه همه ما در معرض خطر باشیم، استعفا دهیم. ما در این باره آژانس داریم. ما نمی خواهیم برویم و مدل های خود را به کار گیریم، اگر آنها واقعا این احتمال را داشته باشند که باعث خطر بشریت شوند. در یک آزمایشگاه مرزی، شما توانایی کار بر روی هم تراز به نقطه ای که شما احساس نمی کنید بیش از خطر psilon برای جهان در استقرار مدل های خود را.
(در بحث در مورد سطوح خطر، واژه یونانی epsilon اغلب به عنوان یک سهامدار ریاضی برای آستانه قابل قبول استفاده می شود. چن نمی گوید که psilon چه خواهد بود.)
هنگامی که از رهبران فناوری خواسته می شود تا ضعف هوش مصنوعی را توجیه کنند، نقطه صحبت کردن آنها این است که سویه ها – از کمک به درمان بیماری ها برای رسیدن به منابع پاک کننده انرژی – بسیار بیشتر از هزینه های فوری است. درد های کوتاه مدت، دستاوردهای بلند مدت
اما به عنوان ضعف بالا، آیا این مورد سخت تر می شود؟ آیا نقطه ای وجود دارد که چن احساس می کند کمتر از آن است که او چیزی شگفت انگیز و بیش از آن می سازد که آیا او به سادگی در حال کاهش آسیب است – آتش سوزی به جای ایجاد آینده بهتر؟
او می گوید: «زمان آن است که مزایای هوش مصنوعی را به بشریت تحویل دهیم. زمان آن است که شروع به کار بر روی مشکلات عمیق در کشف مواد، بر روی مواد، در برنامه های علمی که در واقع زندگی مردم را تغییر می دهد.
"بله، خطر کمی وجود دارد که ما دچار آن هستیم، اما همه این مزایا را می بینیم." فکر می کنم باید این کار را کمتر از یک چیز انتزاعی انجام دهیم. اگر مردم واقعاً می توانند این را ببینند، فکر می کنم به آن اعتقاد خواهند داشت.»
💻 کدزن | طراحی سایت و سامانههای آنلاین
🚀 ایدهات رو به یک محصول آنلاین حرفهای تبدیل کن
🌐 www.codzan.ir
💬 طراحی • توسعه • پشتیبانی